Google Spreadsheetの公式add-on 'Google Analytics'が更新しV4対応したものの機能はV3とほぼ同等

Google Spreadsheetで公式に提供されていたGoogle Analytics Add-onが更新されました。
ユーザ数が今日現在で400,062人。

今までの設定シートはコピーされ新しいフォーマットである `Report Configuration` が作成されることでユーザが何か作業を必要とする必要はなく移行が完了していますが、あくまでV3版をV4に置き換えをしただけのようです。


GoogleがAPIのバージョン4を出してから、Google側もアップグレードしたいだろうなーとは思っていました。今年のはじめあたりにGoogle API Console側からV3の設定メニューを恐らく事故だと思うのですが消えていたりしましたし。

左がV3、右がV4

復活したもののすでにアイコンすら無くなっていますけどw
移行は自動で完了したもののV4としての恩恵は受けられません。V4で実現可能な

  • 2期間のデータ比較
  • pivot
  • cohort
  • LTV
あたりは実現されません。(参考)
またdimensionやmetricの書き方等はV4のJSONの記述をそのまま許容するという苦肉の策が取られています。(ドキュメント)


基本的にV3のように指標のカンマ区切り、改行区切りで記述することを許容しつつJSONフォーマットも許容すると。
仕方ないかなと思いつつも思わず苦笑いするところですね。V4のパラメータを一部hidden parametersとして指定を可能としていますがsampling levelに関しては旧addonでも存在していたのでデフォルトで指定できるようにしてあげても良かったんじゃないかと思ったりはします。移行に際して今までもEnumだったのでそのまま `LARGE` 等へ置換してあげればいいだけですし。

このあたりSpreadsheetでは列が非表示となっているようです。


個人的には去年暮れあたりからV3の利用、addonの利用は停止していますが過去に作ったファイルの一部が利用していたので50通くらいメールで「アップデートしといたから!」という内容を受信しました…
今日中に必要なものの9割は利用停止とV4移行を個人で行ってしまおうかと思っています。

改めて考えるCore Reporting V4 APIのメリット

Core Reporting APIのV3を利用している人でV4になかなか踏み出せないという方も多いのではないかと思います。V4がリリースされて1年ちょっと。V3からV4への移行によるメリットは以下目的に集約されるのではないでしょうかということで、少しまとめてみようと思います。

Table of Contents

  1. APIリクエスト数の減少とそれに伴う分析時間の短縮
    1. 2期間のデータ比較
    2. 積み上げグラフ用(historical bucket)データ抽出
  2. V4のみサポートされる機能の利用
    1. pivot
    2. Cohort
    3. LTV
  3. その他注意点なども
    1. session dateが存在しなそう…
    2. V3であったfilterは存在するけど機能分裂
    3. 欲しい機能

APIリクエスト数の減少とそれに伴う分析時間の短縮

■2期間のデータ比較

従来2期間、例えば前年比や前週比、その他特定期間同士を比較する場合V3では2期間それぞれでAPIを叩き、その結果を自分たちで比較する必要がありましたが期間を配列で2つ渡すことが可能となったことによって1リクエストで完結することができるようになりました。

[{
  startDate = 2017 - 11 - 22,
  endDate = 2017 - 11 - 22
}, {
  startDate = 2016 - 11 - 22,
  endDate = 2016 - 11 - 22
  }]

V4では2期間を配列で入れ込みます。期間を複数指定した場合はsortの仕方として2期間の差に対するソートと以前のGoogle Analyticsで存在していた加重平均順が指定できるようになります。例えば2期間のユーザ数の差の降順で表示したい場合のorderBy指定は以下のような指定になります。

{
  orderType = DELTA, fieldName = ga: users, sortOrder = DESCENDING
}

DELTAは差、SMARTが加重平均となります。
2回投げてからSpreadsheetなどでデータを整形するとなると抽出されたデータが100%データであれば問題ありませんが、filterやデータサイズによって返却されたデータの中でしか分析ができません。この部分が解消された今回の2期間比較は大いに利用する価値があると思います。

■積み上げグラフ用(historical bucket)データ抽出

個人的にはこの機能が一番分析スピード、Google Analytics APIへのリクエスト数削減となりました。

例えばdimensionの値によってこのようなグラフを作成したい場合、今まではfilterで個別の条件、この場合は6条件指定してデータを抽出してから一つにデータを並べて描画する必要がありました。
(6リクエスト)

しかしながら今回historical bucketが発生したのでこのデータ抽出は1リクエストで完結します。(6 -> 1リクエスト)

これはかなりデータ抽出時間の削減になります。
historical bucketでは指定した値は範囲の上の値となります。例えば ['1', '3', '4', '7'] という配列が指定された場合、1未満、3未満、4未満、7未満、7以上というデータが返却されます。

V4のみサポートされる機能の利用

■pivot

これが地味に嬉しい機能ですね。GAのpivot…、あまり利用されている方をお目にかかることはない機能ではあります。pivotを利用することで抽出できるデータの幅が広がりますし、2期間比較のところで述べた内容と同じではありますが複数回リクエストしてからSpreadsheetなどでデータを整形するとなると抽出されたデータが100%データであれば問題ありませんが、filterやデータサイズによって返却されたデータの中でしか分析ができないのです。

Google Analyticsの画面側での領域を以下のように3つに分解すると


APIでは以下のような位置づけになります
① : dimensions
② : pivot.dimensions
③ : pivot.metrics

この辺はあまりヘルプでも詳しく説明されてはいないように思います。

■cohort

コホートも時々見る程度で利用しているという人はあまりお目にかからないような気はしますが、個人的にはスマートフォンだとAndroidとiOSで定着に差がありそうだとか、いくつかsegment別定着数、定着率ウォッチ用に使っていたりします。
OSや何か条件によって定着って結構ぶれますし、普段からなんとなくデータを見ておかないと特にリリース後の異常値に気づかないということもありますので。

例えばAndroidにセグメントをかけつつcohortデータを出す場合は

{
  viewId = , cohortGroup = {
    cohorts = {
      dateRange = {
        endDate = 2017 - 12 - 21,
        startDate = 2017 - 12 - 21
      }
    }
  }, samplingLevel = LARGE, metrics = {
    expression = ga: cohortActiveUsers
  }, dimensions = [{
    name = ga: cohort
  }, {
    name = ga: cohortNthDay
  }, {
    name = ga: segment
  }], segments = {
    dynamicSegment = {
      name = os,
      sessionSegment = {
        segmentFilters = {
          simpleSegment = {
            orFiltersForSegment = {
              segmentFilterClauses = {
                dimensionFilter = {
                  expressions = Android,
                  dimensionName = ga: operatingSystem,
                  operator = EXACT
                }
              }
            }
          }
        }
      }
    }
  }
}
こんな感じになります。(viewIdは抜いています)

※注意点 : 期間指定の仕方
ga:cohortNthDay : startとendが同一日
ga:cohortNthWeek : startが日曜日、endが土曜日
ga:cohortNthMonth : startが1日、endが月末最終日

個人的にはこの期間指定、使いにくいなーって思っています…。

■LTV

今唯一このLTV機能だけは利用していないので若干間違っている部分があるかもしれないのですがAPIでのLTVはcohortの拡張でCohortGroupの中にlifetimeValueが存在しています。
lifetimeValueはtrue,falseの指定をする形になりますのでcohortの期間に関する注意点は同様となります。

{
  viewId = , cohortGroup = {
    lifetimeValue = true,
    cohorts = {
      dateRange = {
        endDate = 終了日入れる,
        startDate = 開始日入れる
      }
    }
  }, samplingLevel = LARGE, metrics = {
    expression = ga: cohortActiveUsers
  }, dimensions = [{
    name = ga: cohort
  }, {
    name = ga: cohortNthDay
  }]
}

こんな感じになるのかなと思います。(viewIDや期間は未指定)

その他注意点など

■session dateが存在しなそう…

session date…これはstack overflowとかを見てもcohortで書けよ的なものも見受けられますし、Googleのヘルプもcohortに紐づくものか?と思われる書き方がされているし、ちゃんとした仕様を把握している人、Googleにも実はいないんじゃ…と思わなくもなく。むしろ開発側の認識と企画側の認識の差が生み出した機能!?

まずはsession dateとはなんぞや?という事ですがsegmentにある「セッション日」です。

これは特定の期間にセッションが存在しているということしか意味していないような動きをしています。その証拠にとあるアカウントでデータを抽出してみたものを見てみます。

分かりやすいようにコホートページで且つセグメントとしてセッション日が特定の日であるという条件にします。

そうするとリテンション割合データはこの通り表示されます。

即ち100%と表示されているのがセグメントで指定した日ですね。
この「セッション日(session date)」には指定した日にセッションが存在したという条件しかかかっていない事が分かると思います。

V3ではこのsession dateには `dateOfSession` というパラメータが存在しましたが、V4では存在しません。この `dateOfSession` = session dateなのか?という点については過去に別のpostをしましたが。

V4で日付を指定するには分析期間としてのdateRangeとコホートのdateRangeがありますが、segmentでは存在しません。date使えばいいじゃん…というツッコミもあると思いますがdateはsegmentでは利用出来ません。この `Allowed In Segments` の部分。


その他date関連はすべてセグメント指定には利用出来ない事になっています。
一方でcohort内で指定される日付については指定しなくても指定しても最初のアクセス日としか処理されません。


なので現状は存在しないと思われます。
基本V3で動いていたScriptをV4に移行しているのですが、session dateまわりのものだけは移行出来ませんでした。

すみません…このsession dateまわりに悩みつつ利用しつつはや4年くらい…以前Googleの人に直接聞いたものの個別案件には回答出来ないと言われたままw (聞き方が悪かった説が濃厚

■V3であったfilterは存在するけど機能分裂

APIのV3ではデータに対して何らか条件で抽出する場合、segmentとfilterの2種類存在していました。これはGoogle Analyticsの画面上でも同様で意識的な使い方としては…
  • segment : 解析するデータの母集団に対するフィルタリング
  • filter : 返却されたデータに対するフィルタリング
だと思っています。(あまり意識していなくてもGoogleがうまく抽出しているように見えるような事もある)
segmentは例えば検索経由で流入した人とか、新規ユーザといった分析対象となるユーザやセッション、セッション中のヒットなど母集団を絞り込む機能です。そのためこのsegmentの設定を間違えるとそもそも対象となる母集団にゴミがまじったりといった副作用があります。一方でfilterは返却値に対するフィルタで例えば返却されたURLの中から `hogehoge` という文字列が含まれるものを絞り込むといった用途になります。

例) 検索経由で流入したユーザがランディングしたページがサイトTOPページとなっているセッション数は?

この場合…

segment : 検索経由で流入したユーザ (ユーザレベル , 検索経由)
metric : セッション数
dimension : ランディングしたページURL(ga:landingPagePath)
filter : ランディングしたページURLがサイトTOP (ga:landingPagePath == '/' )

といった感じになります。
即ちdimensionとそれに対するfilterです。

今回V4になってfilterはいくつかに分解されました。
  • サーバ側filter
    • dimensionFilterClauses : dimensionsに対するフィルタ
    • metricFilterClauses : metricsに対するフィルタ
  • 返却データに対するfilter
    • filtersExpression : V3のfilterと同義
まず大きく分けてデータ抽出に対するフィルタと返却されたデータ群に対するフィルタの2種類が発生しました。

今までのV3のフィルタはmetricsに対するフィルタもdimensionsに対するフィルタも書けた訳ですが、抽出後データへのフィルタ一本化されていたように思っています。今回V4化でデータ抽出時にsegmentをした母集団に対して更にdimensions、metricsに対しフィルタをした状態でデータを返却可能となりました。そしてもしそれで足りなかった場合は返却されたデータの中から更にfilterをかけるという構造です。
ただし個人的には従来のフィルタは基本的にClause側へ完全に寄せ、filtersExpressionはV3との互換性確保のために一応用意されているものではないかと感じています。(次のバージョンでは消える…とか)

filtersExpressionではV3のfilterと全く同じ文法で書くことができるようになっています。

■欲しい機能

時々あったらいいなぁ、もしくはあったほうが分かりやすいのでは?と思う機能があります。
  • pivotのmetricsに対するorderby機能
pivotのmetricsは常に降順になっているようで、確かに普通に使っている分には事足りてはいる訳ですが、metricsに対する指定できたら面白いかも…とか、dimensionsの項目に対してアルファベット順とかデータ抽出時に指定出来たほうが良いのでは?と思ったりしています。まだ必要に駆られている訳ではないのですが、もし必要となった場合Spreadsheetに一回出力してから…というのもイケていないので。


さて以上のように長々と書いたわけですがV3で扱いにくい部分が改善され、新機能が利用できるようになったと単純に考えてもメリットはあるように思いますが、何より分析前のデータ抽出時間が短縮するという事、さらに各自の分析ツールに1度でデータを投入できたりといったメリットも結構大きいと思います。

標準ブラウザなのかそうじゃないのか、それが問題だ

モバイルサイト側で標準ブラウザってどれだけ使っている人がいるんだろう…。
そんな疑問をもってGAのブラウザ分布を見て「Android Browser」を見に行くパターン、それはアウトです…


User-Agent的にも当然ではあるのですが、Chromeに分類されているパターンも非常に多い。Chromeで非常に古いバージョンを利用している人とか気になりません?


バージョンを眺めていると古いバージョンは特定のバージョンに偏って、そのバージョン以外はほとんどセッションが無いという事になるのですが…


ほら…Android標準ブラウザの Chrome/40.2214.89 と一致。
全部のキャリアのUser-Agentを見たわけではありませんが、通常のChromeであれば少なからずどこかで強制アップデートがかかっていて、現状61あたりにはなっているっぽく見えます。

一旦ver.56以上をChromeユーザとみなすとか、そういう感じにしないとGAのChromeが増えてきた = Chromeユーザばっかりではないよ、という事ですね。

GAテストパターンに対するセグメントが意外と厄介

Google Analyticsのウェブテスト、このウェブテストのテストパターンに対するセグメントの作成方法を最近ヘルプでの記載を見ました。他の方に指摘されて示された訳ですが、「条件」ではなく「シーケンス」で設定する必要があります。

■Googleヘルプのキャプチャ

これだけでも結構厄介というか想像がついていないわけですが…
なんでシーケンスなのにSTEP1だけ指定するだけのセグメントなの…と。全く理解出来ませんがデータ的にはちゃんと取れていそうなのでまぁこれは覚えれば良い内容ということで整理しましょう。

でも、更に不可解なのがこのウェブテストに対するセグメントが分析期間の指定によりデータが左右されるという事。

普段API側で作業をしているのでAPIとして具体的に説明すると…

■テスト期間
2017-10-01 〜 2017-10-10

■データ抽出1
start-date -> 2017-09-01
end-date -> 2017-09-30
metrics -> ga:users
segment -> users::sequence::ga:experimentId==xxxxxxxx

■データ抽出2
start-date -> 2017-09-01
end-date -> 2017-10-10
metrics -> ga:users
segment -> users::sequence::ga:experimentId==xxxxxxxx

の2パターンでデータを抽出するとします。データ抽出1とデータ抽出2では分析期間のend dateが違うだけです。
通常のcondition(条件)の場合、セグメントに入ってくるセッション開始日やセッション日などの日付とデータ抽出用のstart date、end dateは独立していますが、上の例のsequenceが問題なのかウェブテストが問題なのかはまだ検証が必要ですが、この場合は異なってデータが抽出されてきます。

■結果
データ抽出1 : 0
データ抽出2 : >0 でデータがちゃんと抽出される

つまりユーザレベルでデータを抽出しているにも関わらず解析期間内にウェブテスト期間を含んでいないと正しくデータが抽出されない事になります。
これは結構問題だなと感じますね…。

ウェブテスト前後のデータ比較をするならそこまで問題は発生しないかもしれませんが。
シーケンスで設定しなければならない点も含め、なんでこんな動きしてるんだろう…と1日に2度驚いた…という話でした。

[BigQuery]Custom Dimensionsに対するQuery

GoogleのhelpでもBigQueryのCookbookとしてCustom Dimensionsに対するQueryの書き方があります。

■ヒットレベル
SELECT fullVisitorId, visitId, hits.hitNumber, hits.time,
MAX(IF(hits.customDimensions.index=1,
hits.customDimensions.value,
NULL)) WITHIN hits AS customDimension1,
FROM [tableID.ga_sessions_20150305]
LIMIT 100

■セッション・Userレベル
SELECT fullVisitorId, visitId,
MAX(IF(customDimensions.index=2,
customDimensions.value,
NULL)) WITHIN RECORD AS customDimension2,
FROM [tableID.ga_sessions_20150305]
LIMIT 100

カスタムディメンションはBigQueryだとヒットレベル・セッション/ユーザレベル・プロダクトレベルの3つあります。

hit : hits.customDimensions
session/user : customDimensions
product : hits.product.customDimensions

上の例だとcustomDimension2には数値が入りMAXを取得する感じですが入ってる文字列を抜き出してjoinに使いたいとなった場合どう取得すれば良いかと少し悩みました。

パット見て最初わからなかったのは `customDimensions.value` の書き方の部分なのですが。

国内・海外含めコミュニティやブログを参照しつつ色々ためしてみて、一部抜粋&改変でちょっとイマイチな部分がありますが、最終的にこんな感じで書きました。

  (
  SELECT
    t2.id AS id,
    t2.query AS query
  FROM (
    SELECT
      cd.value AS id,
      hits.page.searchKeyword AS query
    FROM
      `xxxxxxxxxxxxxxxxxxxxxx.xxxxxxxxxxxga_sessions_2017092*`,
      unNEST(customDimensions) cd,
      unNEST(hits) hits
    WHERE
      cd.index = 1
      AND cd.value IS NOT NULL
      AND hits.page.searchKeyword IS NOT NULL
    GROUP BY
      cd.value,
      hits.page.searchKeyword) t2 ) t1

WITHIN RECORDを使うやり方やFLATTENを使うやり方、UNNESTを使うやり方などもあり、FLATTEN/UNNESTはRECORDタイプをフラット化して取り扱うやり方ですね。
結構customDimensionsをBQから抜いてる人は多そうですがネット上にはあまり情報が無いなという印象。普段からQueryを書き慣れている人からするとRECORDタイプとかもそんなに苦もなく処理できるんですかね。

Data Studioの正規表現、エスケープは2バックスラッシュ

メモ的な投稿ではありますが、Googleの正規表現だからといってre2ではなく2バックスラッシュを利用しなければなりません。

いつもの事ではありますが日本語のヘルプには書かれていません


英語側のヘルプには記載されています。


最後の2 backslash charactersという部分ですね。
パースエラー、パースエラーと怒られて何でだよ!と検索しつつ試してみたら通って、「なーんだヘルプに書いてあるじゃん」と思ったら日本語側には無いという罠ですね。

PWAによるオフライン時のPVカウント実装 `sw-offline-google-analytics`

Googleのオフィシャルで昨年アナウンスのあったnpmモジュール `sw-offline-google-analytics` を利用したオフライン実装は皆さん述べられている通り非常に簡単でしたのでメモ。


# 準備
## localhostにサンプルのPWAサイトを導入

1. node.jsをローカルへインストール
2. localの適当なディレクトリにPWAコンテンツを格納
3. `sw-offline-google-analytics` を導入

`npm install --save-dev sw-offline-google-analytics`

# service-worker.js を変更
## Googleドキュメントの通り service-worker.js に2行追加


※まだ最新版のバージョンは v0.0.25

## 計測が分かりやすいようにGA / GTMを設定
### Google Analytics側はカスタムディメンションを設定


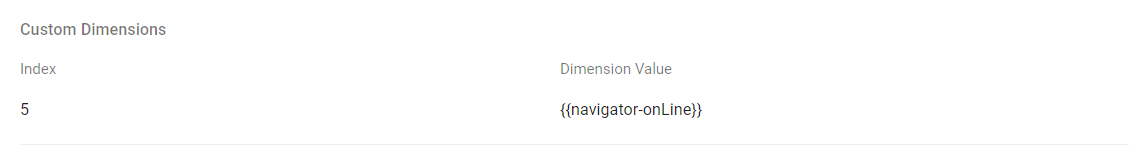
### Google Tag Manager側は navigator.onLine でステータス把握
#### variable


#### tag側はカスタムディメンションにセット


# 実際の動きを確認
## ONLINE
通常どおりGA側にPVが送られている


## OFFLINE
GAへの送信がコケる


同時にIndexedDBへ格納される(4回OFFLINEアクセスをしてコケた時のキャプチャ)


## OFFLINE to ONLINE
まとめて送信される


# まとめ
moduleのバージョンが0.0.25なので今後のUpdateなども行われそうですが実装的には非常に簡単にできそうです。計測も問題はなかったのですが、数秒以内に何度もOFFLINEでアクセスをするといった場合はPVカウントがイマイチな気も少ししました(ネットワーク側の問題かも?)。ここは要検証。

ただ…注意事項としては
You should note that Google Analytics hits older than four hours are not guaranteed to be processed, but resending somewhat older hits "just in case" shouldn't hurt.
の部分です。 4時間より以前のものに関しては保証されないというヤツですね。再送信可能と書かれているものの `保証されない` だけで二重にカウントされるのも嫌ですしね。
IndexedDBから送信された分だけ消えるのかとか、その辺りも確認が必要かもしれないですね。